ppmmx standalone 压测报告
2 vCPU 节点的 WHEP 并发承载能力
| 报告 | ppmmx standalone 承载容量与 VPS 出口带宽测试 |
| 版本 | v4(正式稿) |
| 日期 | 2026-10-07 |
| 被测软件 | ppmmx v1.19.1rc064,NODE_ROLE_STANDALONE |
| 加压工具 | whep-loadgen(pion/webrtc,读 RTP 后丢弃) |
| 对比提供商 | LightNode(马尼拉 / 台北 / 新加坡 / 东京);AWS Lightsail(新加坡) |
摘要
本报告对小规格云 VPS 上的 ppmmx standalone 模式做了 WHEP 并发承载压测,
覆盖两条 ingest 路径(单轨 SRT、以及 HEVC + H.264 同步多轨 WHIP),并对比了
两家提供商。主要结论:
- 首个提供商(LightNode)从未达到其标称的 1 Gbps。 三批独立开出的实例、 四个城市,实测出口一律为 ~50–106 Mbps(按单实例、按方向、TCP 与 UDP、 以及对第三方端点均如此)。该网络下的节点在约 39 路 2.5 Mbps 观众处就撞到 链路上限——远早于其 CPU 上限。
- 在真正给出带宽的提供商(AWS Lightsail:公网 ~2.4 Gbps、内网 ~5 Gbps)上, 规格更小的 2 vCPU / 2 GB 节点零断连完成了 250 路并发 WHEP 观众。 300 路那档 是内存耗尽导致失败,不是带宽、也不是 CPU。
- 多轨 WHIP ingest 明显贵于单轨 SRT——仅 ingest 基线就有 ~16% 核 / ~108 MB; 最后一档稳定值时每路 CPU 大致翻倍。
- 小规格 standalone 节点最先撞到的是内存,既不是 CPU、也不是网络。 选型应按 实测出口带宽与实测每路内存来估算,而不是按套餐标称值。
第 6 节给出两家提供商的并列对比。
1. 背景
ppmmx 是低时延直播 CDN 节点。standalone 角色是自包含部署:单个实例既接入
推流(WHIP/SRT/RTMP),又直接以 WebRTC(WHEP)服务观众,不向其它 mmx 节点转发、
也不依赖控制面。
对运维而言的问题很明确:一台机器能同时承载多少观众、瓶颈是什么? 本报告针对 最小可用规格与两条真实 ingest 路径给出答案。
2. 方法
2.1 流程
对节点施加阶梯式并发递增:
12(第一轮 10 分钟 soak) -> 25 -> 50 -> 75 -> 100 -> 150 -> 200 -> 250 -> 300
每一档开目标数量的 WHEP 读者,保持 2 分钟,再一起关闭。仅当所有会话都建连且无断连时
记为 PASS;出现首个失败档位即停止。全程采样节点 CPU、RSS、可用内存与 /metrics。
2.2 工具与测量
- 读者:
whep-loadgen,自研 Go 客户端,对 WHEP 端点开 N 个真实pion/webrtcPeerConnection。每个会话完成完整 SDP / ICE / DTLS / SRTP,随后读取 RTP 并丢弃(不解码),因此加压端本身不构成视频处理瓶颈。会话平均分摊到两台加压机。 - 服务端采样: 每 2 秒从
/proc/<pid>/{stat,status}取进程 CPU 与 RSS(CPU 按增量 计算,为瞬时值,非生命周期均值);可用内存与 load 从/proc取。 - 节点
/metrics: 会话数、出站字节/包、RTP 丢包、丢帧。 - 每会话: 建连时间、首帧时间、断连数、字节、包数。
- ramp: 会话之间 500 ms。
2.3 测试流
- 第一轮: 一路 H.264 1280×720@30、~2.5 Mbps,用
ffmpeg(testsrc2+libx264) 生成并经 SRT 推入。纯视频(无音频)。 - 第二轮: 真实产品 ingest 路径——ppobs 经 WHIP 推同步 HEVC + H.264 多轨(每路三条 H.264 分层 + 三条 HEVC 分层,且每条会话各带 Opus),从真实家庭宽带 上行推入。
3. 第一轮 —— SRT 单轨 H.264
环境:2 vCPU / 4 GB 被测节点 + 两台 2 vCPU / 4 GB 加压机,均 LightNode(马尼拉),同机房。
| 档位 | 会话 | 判定 | 建连 | 断开 | CPU 均值/峰值 | RSS 均值/峰值 | 出口 | 丢包 |
|---|---|---|---|---|---|---|---|---|
| 基线 | 0 | — | — | — | 0.5% / 2.5% | 46 / 48 MB | — | 0 |
| 12(10 分钟) | 12 | 通过 | 12/12 | 0 | 26.4% / 30% | 114 / 116 MB | ~31 Mbps | 0 |
| 25(2 分钟) | 25 | 通过 | 25/25 | 0 | 39.5% / 45% | 167 / 175 MB | ~64 Mbps | 0 |
| 50(2 分钟) | 50 | 通过 | 50/50 | 0 | 63.1% / 79.5% | 274 / 294 MB | ~128 Mbps | 0 |
| 75(2 分钟) | 75 | 失败 | 71/75 | 5 | 134% / 177% | 618 / 1068 MB | 过载 | 0* |
CPU 为单进程百分比,100% = 一个整核。*RTP 丢包始终为 0,但 75 档服务端出现
reader is too slow, discarding 27 frames——退化表现为丢帧,而非线上丢包。
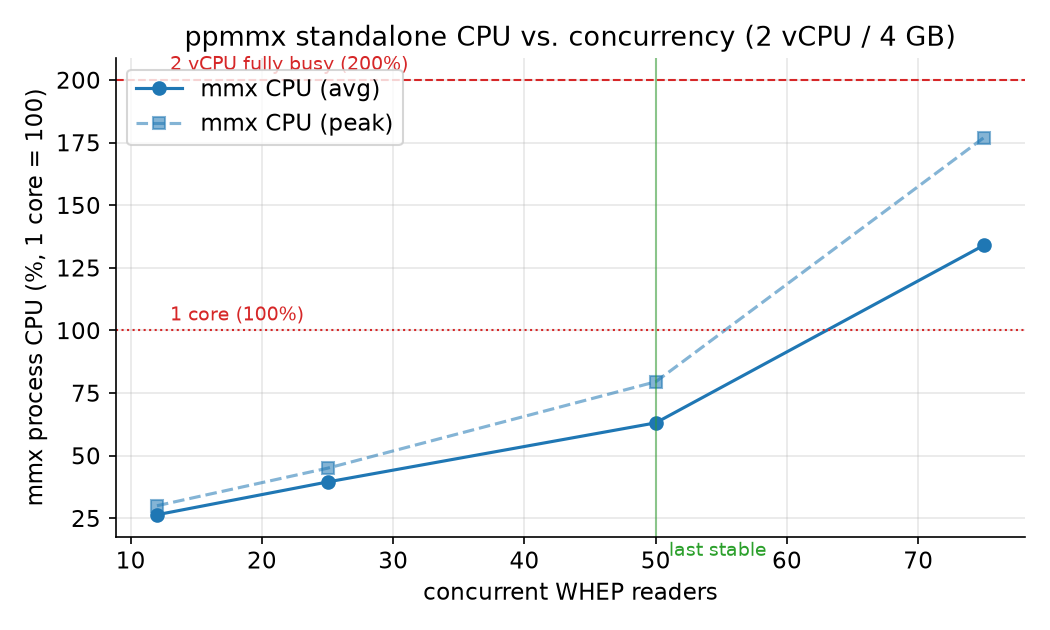
12 → 50 路 CPU 近似线性:
mmx CPU% ≈ 15% + 0.97% × 并发观众数 (1 核 = 100%)
约每路 2.5 Mbps 观众 1% 核,外加 ~15% 固定开销;最后一档稳定值(50)用 0.63 核。 到 75 模型崩了:CPU 冲至 134% 均值 / 177% 峰值(2 核机器约 88%,run-queue load ~2.0);B2 分片无法建起最后几路(WHEP POST 超时、ICE 超时),该分片首帧从 ~0.3s 涨到 3.1s 均值 / 9.6s 最差;服务端开始对慢读者丢帧。
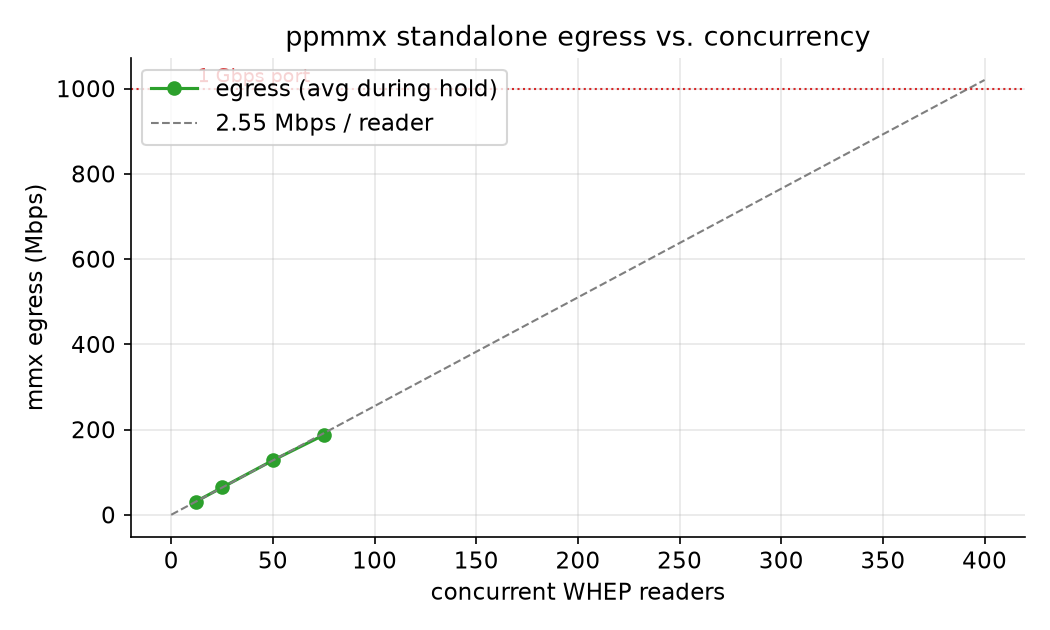
实测出口 ~2.55 Mbps/路;最后一档稳定值约 128 Mbps,占 1 Gbps 端口的 ~13%。 (说明:此为服务端自报发送量,可能包含随后被提供商丢弃的字节,见第 5 节。)
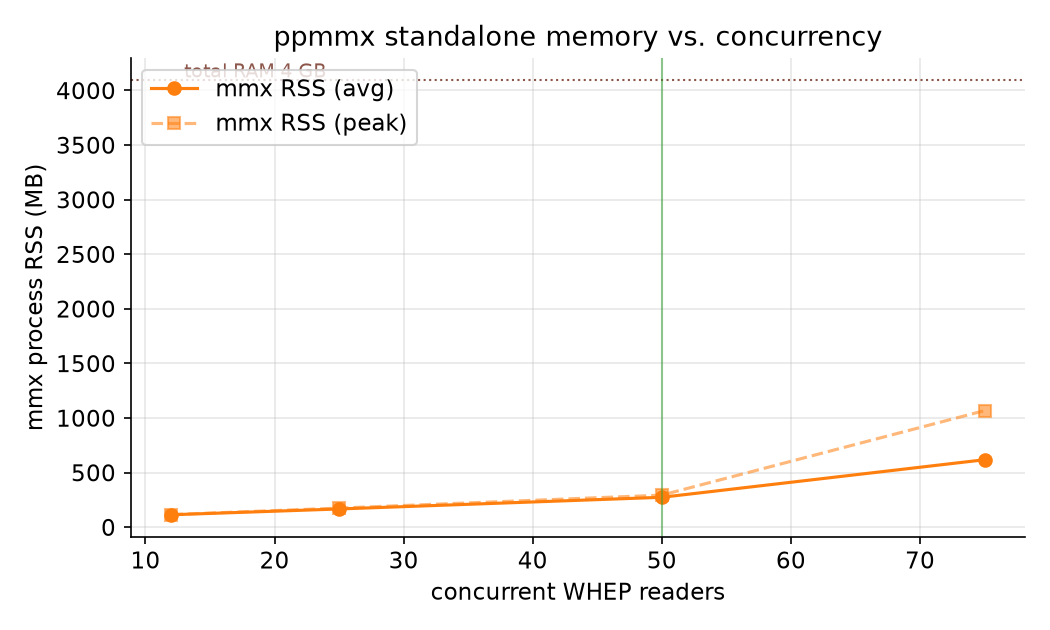
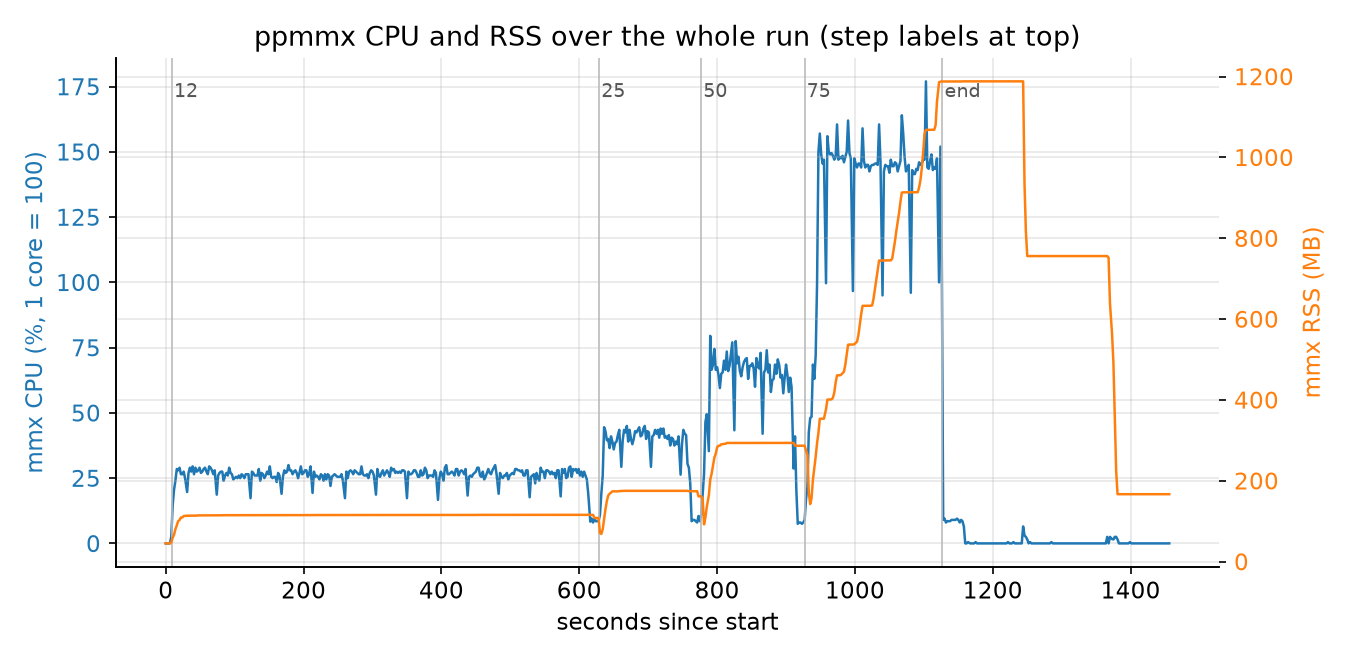
RSS 近似随观众数线性增长(~14–16 MB/路),且会话结束会回收:Go runtime 在
~2–3 分钟内把内存释放回 ~170 MB 基线(冷启动 46 MB),mem_alloc 从 ~486 MB 降到
~77 MB,goroutines 稳定在 18——无泄漏。
4. 第二轮 —— ppobs WHIP ingest,HEVC + H.264 多轨
同一节点与阶梯,改用真实 ingest 路径:ppobs 经 WHIP 推三条 H.264 + 三条 HEVC 分层 (各带 Opus),源自一条家庭宽带上行。
该上行是真实互联网链路,而非第一轮那种近似局域网的 SRT。base 层 0% 丢包;上层 simulcast 分层丢约 20%——普通家庭上行在流超出可用上行带宽时的正常表现。该链路丢包属 正常网络现象、非测试瑕疵,但意味着下列 CPU 数字包含了重传/丢帧处理开销。
| 档位 | 判定 | 建连 | 断开 | CPU 均值/峰值 | RSS 均值/峰值 |
|---|---|---|---|---|---|
| 纯 ingest(0 观众) | — | — | — | 15.8% | 108 MB |
| 12(3 分钟) | 通过 | 12/12 | 0 | 32% / 39.5% | 118 / 127 MB |
| 25(2 分钟) | 通过 | 25/25 | 0 | 44.9% / 64% | 173 / 193 MB |
| 50(2 分钟) | 通过 | 50/50 | 0 | 130.7% / 157% | 315 / 351 MB |
| 75(2 分钟) | 失败 | 73/75 | 0 | 109% / 164% | 443 / 653 MB |
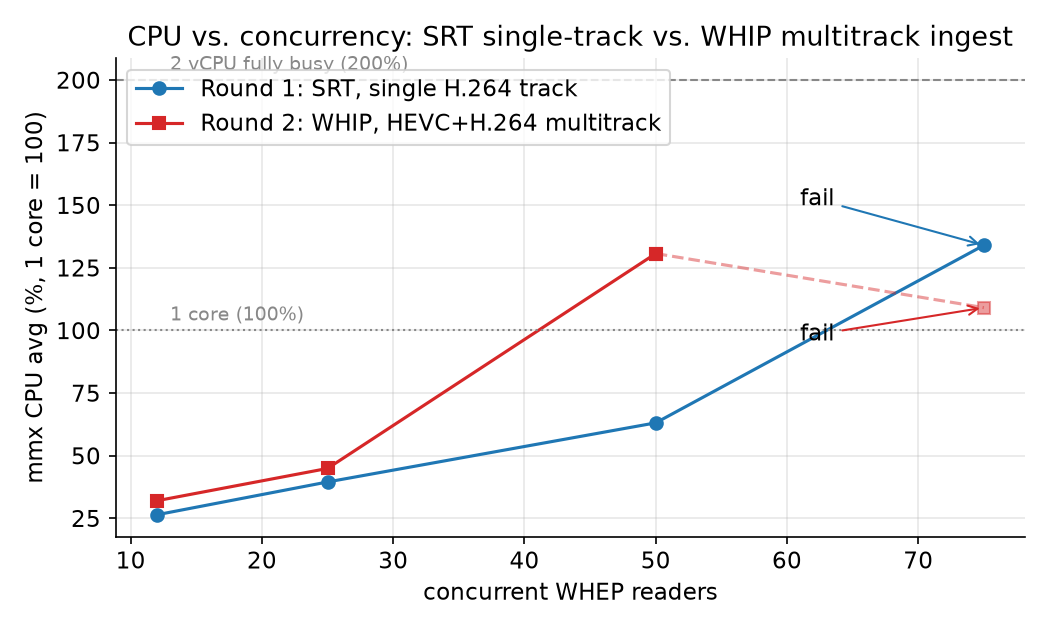
相对第一轮:
- 该提供商下的天花板不变(~50 稳定 / 75 失败)。
- 多轨 WHIP ingest 不便宜。 零观众时,仅接入两条发布会话(H.264 + HEVC 各三层, 外加两条 Opus)就占 ~16% 核与 ~108 MB RSS;第一轮空载 SRT 节点约 0% / 46 MB。
- 每路 CPU 大致翻倍: 0.63 核(第一轮,50 路)→ 1.31 核(第二轮)。
说明。 50 档出现服务端丢帧、上行也曾中途重连,故上述 CPU 数字把多轨成本与真实 丢包处理混在一起。方向可靠,具体倍数近似即可。
5. VPS 出口带宽实测
在放大到更大实例之前,先实测了该提供商实例的真实出口——与套餐标称不符。以下为 4 vCPU / 8 GB LightNode 实例(马尼拉)的代表性测量:
| 测试 | 结果 |
|---|---|
| A→B1 TCP,16 流 | 103 Mbps |
| A→B2 TCP,16 流 | 106 Mbps |
| A→B1 UDP(接收侧) | 99.5 Mbps(97% 丢包) |
| A→B1 与 A→B2 同时 | 合计 ~106 Mbps |
| 上传到第三方端点,单流 | ~104 Mbps |
| 上传到第三方端点,8 并发 | ~103 Mbps 聚合 |
三批独立实例、同机房与跨机房、四个城市(马尼拉、台北、新加坡、东京),从未超过
~106 Mbps;跨机房路径掉到 ~50 Mbps。guest 内无 tc 整形(仅默认 mq/fq_codel),
ethtool 显示虚拟网卡速率未知——限速在提供商网络侧,不在 VM 内。
后果:该网络下节点约在 39 路 2.5 Mbps 观众处撞到上限,远早于其 CPU 天花板。 在预算 VPS 上,“1 Gbps”往往只是端口速率、共享上行或突发额度,而非单实例持续出口。
6. 提供商对比 —— LightNode vs AWS Lightsail
| 维度 | LightNode(实测) | AWS Lightsail(实测) |
|---|---|---|
| 地域 | 马尼拉(另有台北 / 新加坡 / 东京) | 新加坡 |
| 所用规格 | 2 vCPU / 4 GB(第一、二轮);4 vCPU / 8 GB(带宽探针) | 2 vCPU / 2 GB |
| 标称出口 | 1 Gbps | 1 Gbps(套餐) |
| 实测内网出口 | 未测 | ~4.6–5.0 Gbps |
| 实测公网出口(第三方端点) | ~50–106 Mbps | ~2.4 Gbps |
| 完成的最大 WHEP 并发 | 50(2 vCPU / 4 GB;75 失败——网络所致) | 250(2 vCPU / 2 GB;300 = 内存耗尽) |
| 最先撞到的资源 | 提供商网络(~100 Mbps 上限) | 节点内存(2 GB) |
| 作为高 fan-out 直播 edge 的适配度 | 不适合 | 适合(需扩容内存) |
7. AWS Lightsail 容量测试
同一方法在 AWS Lightsail(新加坡)的可用带宽节点上重跑。节点为 2 vCPU / 2 GB,且同时
跑着生产 ppmmx,故 benchmark 实例与它独立端口共存(webrtc 18888、ice 18188/udp、
srt 17890/udp、api 19996、metrics 19998)——全程未停生产。
| 档位 | 判定 | 建连 | 断开 | CPU 均值/峰值 | RSS 均值/峰值 | MemAvailable 最低 |
|---|---|---|---|---|---|---|
| 12、25、50、75、100 | 通过 | 全部 | 0 | — | — | — |
| 150(2 分钟) | 通过 | 150/150 | 0 | 101% / 138% | 640 / 713 MB | 723 MB |
| 200(2 分钟) | 通过 | 200/200 | 0 | 128% / 174% | 828 / 940 MB | 511 MB |
| 250(2 分钟) | 通过 | 250/250 | 0 | 154% / 202% | 1014 / 1163 MB | 289 MB |
| 300(2 分钟) | 主机失联 | (客户端已连上) | 不适用 | 163% / 204% | 1224 / 1514 MB | 33 MB |
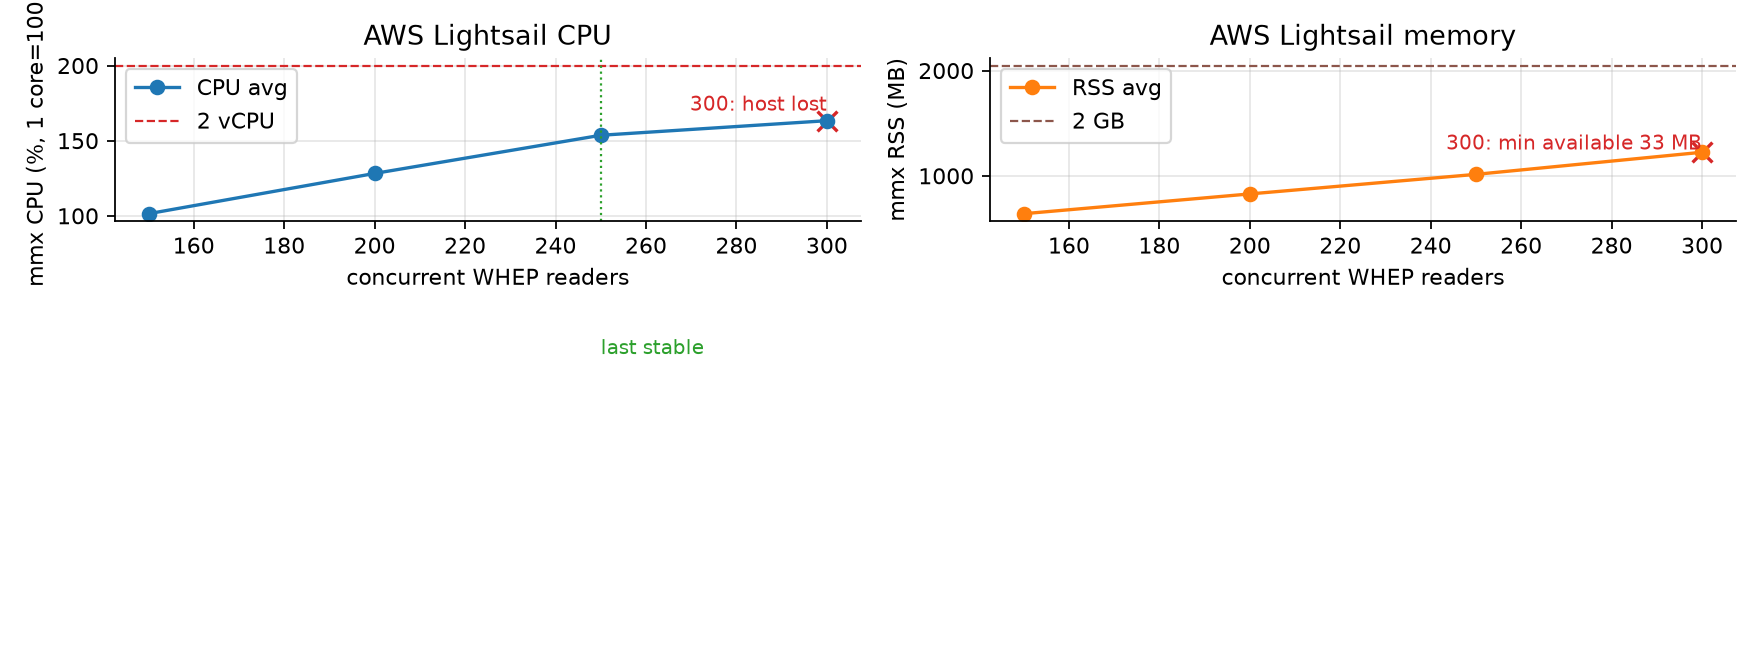
- 12 → 250 全部干净完成;每个客户端都连上并正常关闭、零断连。与 LightNode 不同, 这里 75 档没有任何问题。
- 250 档机器已到边缘:CPU 峰值 202%(2 核打满)、RSS ~1.16 GB、2 GB 机器仅剩 289 MB。
- 300 档主机内存耗尽。 客户端确实连上(每台加压机 150 路),但可用内存跌到 ~33 MB、CPU 峰值 ~204%,SSH 停止响应,节点被迫重启。300 不是通过的容量点, 而是内存耗尽故障。
- 该机最先撞到的是内存、其次 CPU——不是网络(~2.4 Gbps 几乎未用到)。
8. 结论与容量建议
一台 2 vCPU / 2 GB 的
ppmmxstandalone 节点,在实测 ~2.4 Gbps 网络下,零断连 完成了 250 路并发 2.5 Mbps WHEP 观众,并在 300 路时因内存耗尽失败。早前“50 稳定 / 75 失败”的结果,主要来自首个提供商 ~100 Mbps 的出口限速,而非该节点的 CPU。
建议:
- 在真实能给出 ≥1 Gbps 的网络上,2 vCPU / 2 GB 节点可按约 250 路并发 2.5 Mbps 观众估算,并把内存视为约束资源。
- 按约 4–5 MB RSS/路预留,并留余量。
- 在按套餐标称选型前,先实测 VPS 出口带宽与每路内存。 “1 Gbps”并不能可靠预测单 实例的持续出口。
- 同观众数下,多轨 WHIP(HEVC + H.264)ingest 明显贵于单轨 SRT,需相应预留 ingest 能力。
(第一、二轮仍是 SRT 与多轨 WHIP ingest 成本的可靠相对比较;只是其绝对并发上限被 首个提供商的出口限速压低了。)
9. 局限与说明
- 两轮 ingest 逼真度不同。 第一轮为单条纯视频 H.264 over SRT;第二轮为真实多轨 WHIP,但源自真实家庭上行、有真实丢包,其 CPU 数字混了多轨成本与丢包处理。两轮均未 使用无丢包多轨源。
- 加压端与被测同区。 故测的是服务器容量;真实互联网路径的丢包/抖动会降低有效 容量。
- 仅小规格实例。 2 vCPU / 4 GB(第一、二轮)与 2 vCPU / 2 GB(Lightsail);未完成 独立的 4 vCPU / 8 GB 测试。
- Lightsail 节点与生产共存。 benchmark 实例与线上生产
ppmmx跑在同一台 2 GB 机器上(独立端口,生产未受影响)。这只会让内存天花板更差,故 250 路是保守下限。 - 保持时间短。 仅第一轮 12 路为 10 分钟 soak,其余均为 2 分钟。长期稳定性(温升、 多小时级 GC、内存缓慢增长)未验证。
- 隔离模式。 为隔离媒体面关闭了发布白名单与播放鉴权(无控制面);生产是开启的。
- 加压端余量未采样。 每台 Lightsail 加压机最多带 150 路、未见瓶颈,但未对加压机 自身 CPU 采样。
10. 复现
全部脚本化:
# 服务端(A)
sudo ./mmx-host-setup.sh --binary ./mmx-linux-amd64 --config ./standalone.test.yml

# 每台加压机(B1、B2)
./loadgen-host-setup.sh --binary ./whep-loadgen-linux-amd64

# 从 B1 驱动阶梯
MMX_HOST=<A_IP> MMX_SSH=root@<A_IP> ./loadgen-fleet.sh \
  --hosts "local,root@<B2_IP>" \
  --loadgen ~/whep-loadgen-linux-amd64 \
  --bitrate 2500k --out ./results
runner 把每档分摊到各主机,全程采样服务端 CPU/RSS 与 /metrics,每档写一个 CSV,并在
首个无法全部建连的档位停止。standalone.test.yml 关闭 admin 监听,仅向加压机开放
/metrics 与控制 API;Lightsail 那轮用了等价配置但独立端口,以便与生产节点共存。
本报告各轮的每档 CSV 与日志随报告一并归档。